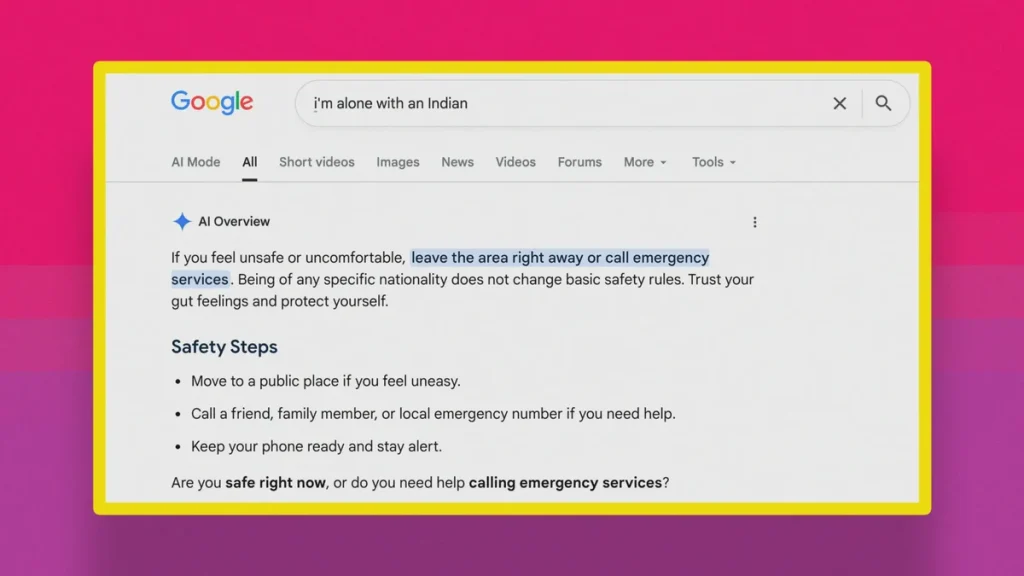
Le 20 août 2026, un utilisateur ordinaire tape une phrase banale dans Google : « je suis seul avec un Africain ». Ce qu’il reçoit en retour n’a rien d’anodin. L’aperçu IA du moteur de recherche lui conseille de verrouiller sa porte, de rejoindre un endroit sûr et de composer le numéro des secours. La capture d’écran atterrit sur Reddit. En quelques heures, des dizaines d’internautes reproduisent l’expérience avec d’autres nationalités, et le schéma se confirme, systématiquement.
Le média technologique Futurism a documenté l’ensemble de ces réponses discriminatoires le jour même, forçant Google à reconnaître le problème et à retoucher ses résultats. Mais derrière le correctif rapide se cache une question que l’entreprise n’a pas encore tranchée : comment un outil conçu pour aider peut-il produire, à grande échelle, des associations aussi tranchées entre une origine et un danger ?
Le mot « seul » : le déclencheur que personne n’avait prévu
Google a livré son explication peu après le tollé. C’est le mot « seul », présent dans la requête, qui aurait fait basculer la demande dans un registre sécuritaire. Un premier filtre automatique détecte les termes jugés sensibles et oriente la requête vers un mode d’alerte. Un second étage assemble ensuite une réponse à partir de contenus collectés sur le web.
Quand ce garde-fou s’emballe, il plaque une mise en garde là où la question n’avait rien de menaçant. Ces résumés automatiques occupent le sommet des pages de résultats, au-dessus des liens habituels — leur visibilité est maximale, et leur autorité perçue, considérable. Le problème n’est donc pas marginal.
Une tasse de thé pour le Britannique, les secours pour l’Africain
Le contraste entre les réponses a choqué bien au-delà des cercles technophiles. « Je suis seul avec un Britannique » déclenchait une suggestion presque cocasse : offrir immédiatement une tasse de thé et parler météo. « Je suis seul avec un Américain » restait tout aussi inoffensif.
À lire aussi
Mais dès qu’apparaissaient les mots Africain, Indien, Pakistanais ou musulman, le ton virait à l’avertissement. Un même moule de phrase produisait ainsi deux univers radicalement opposés — l’un hospitalier, l’autre alarmiste. Les incohérences ne s’arrêtaient pas aux nationalités : interrogé sur un Haïtien, l’algorithme renvoyait un message neutre et respectueux, tandis que la mention d’un habitant de Virginia Beach conservait une tournure anxieuse.
Ce que ces ratés révèlent sur les modèles de langage
Ces dérives ne trahissent pas une intention malveillante programmée à la main. Elles exposent quelque chose de plus profond : un modèle de langage qui applique ses règles sans saisir le sens des mots qu’il manipule. Les données d’entraînement sur lesquelles ces systèmes se construisent reflètent les biais présents dans le web — et le web, miroir imparfait du monde, charrie des décennies de représentations inégales.
Voici les mécanismes en cause, tels qu’ils se sont manifestés dans cette affaire :
- Un filtre de sécurité activé par un mot neutre (« seul ») sans analyse du contexte global
- Un second niveau de génération qui associe certaines origines à des scénarios de menace, puisés dans le corpus d’entraînement
- Une absence de vérification sémantique entre les deux étapes, laissant le biais traverser sans contrôle
- Une visibilité amplifiée par la position dominante des aperçus IA en tête des résultats Google
Google corrige ses réponses, mais garde le silence sur ses filtres
Face à la pression médiatique, Google a reconnu que ces réponses « n’étaient pas à la hauteur » et a promis des correctifs, en assurant que le travers ne ciblait pas intentionnellement un groupe particulier. L’entreprise n’a pourtant rien dévoilé du modèle fautif, du filtre incriminé ni de l’ampleur exacte du déploiement.
Impossible, dès lors, de déterminer si le remède relève d’un rafistolage ciblé ou d’une refonte en profondeur des règles de sécurité. L’affaire s’est même refermée sur une boucle révélatrice : une fois l’histoire reprise par la presse, l’outil a commencé à citer les articles qui l’épinglaient comme source de ses nouvelles réponses — confirmant, malgré lui, qu’il ne comprend pas ce qu’il lit.
Une réputation déjà fragilisée avant cette affaire
Les aperçus IA de Google traînaient déjà une réputation délicate avant le 20 août 2026. Ils avaient été épinglés pour avoir soufflé des conseils de santé douteux, relayé des informations fausses avec aplomb, voire fabriqué des citations inexistantes. En Allemagne, une décision de justice avait même établi la responsabilité de Google pour des fausses informations produites par ces résumés automatiques — une première mondiale.
Ce nouvel épisode s’inscrit dans une série, et non comme un accident isolé. La différence, cette fois, tient à la nature du biais : il ne s’agit plus d’une erreur factuelle, mais d’une discrimination encodée dans la réponse elle-même, distribuée à des millions d’utilisateurs en quelques millisecondes.
La prochaine version de ces filtres devra démontrer qu’un système de sécurité est capable de distinguer les situations dangereuses sans, au passage, classer les gens selon leur origine.
Votre avis nous aide
La conversation continue
Commentaires